 LUCERNA
视觉语言模型中的选择性跨模态对齐:位置接地为何成功,物理推理为何失败
Selective Cross-Modal Alignment in Vision-Language Models: Why Position Grounding Succeeds but Physical Reasoning Fails

摘要 / Abstract
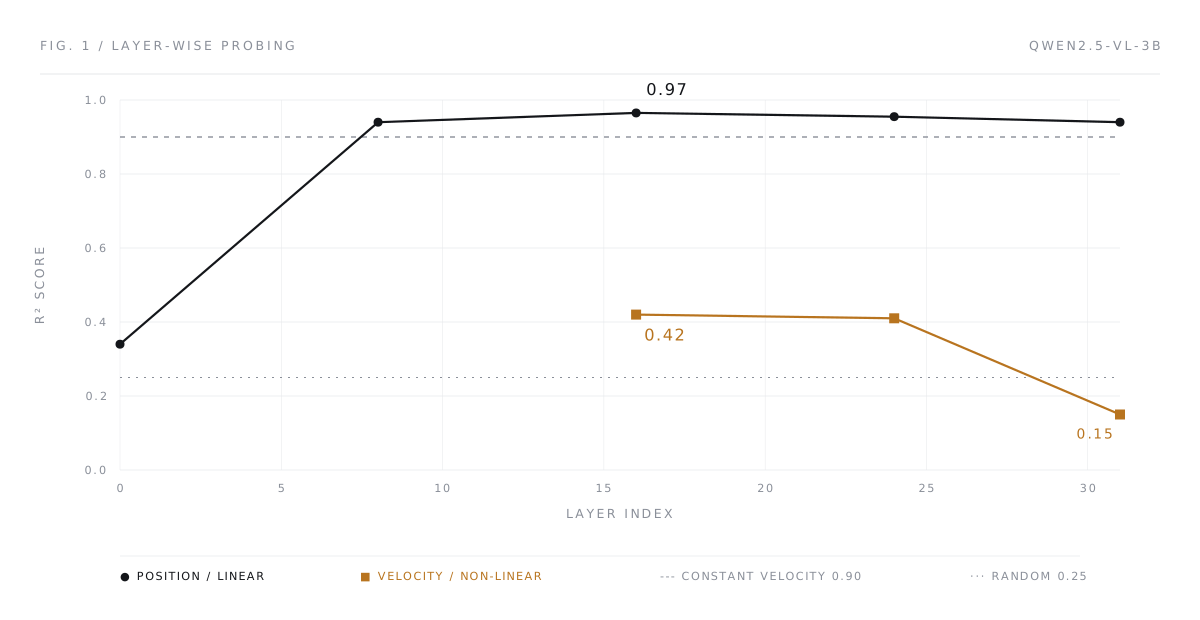
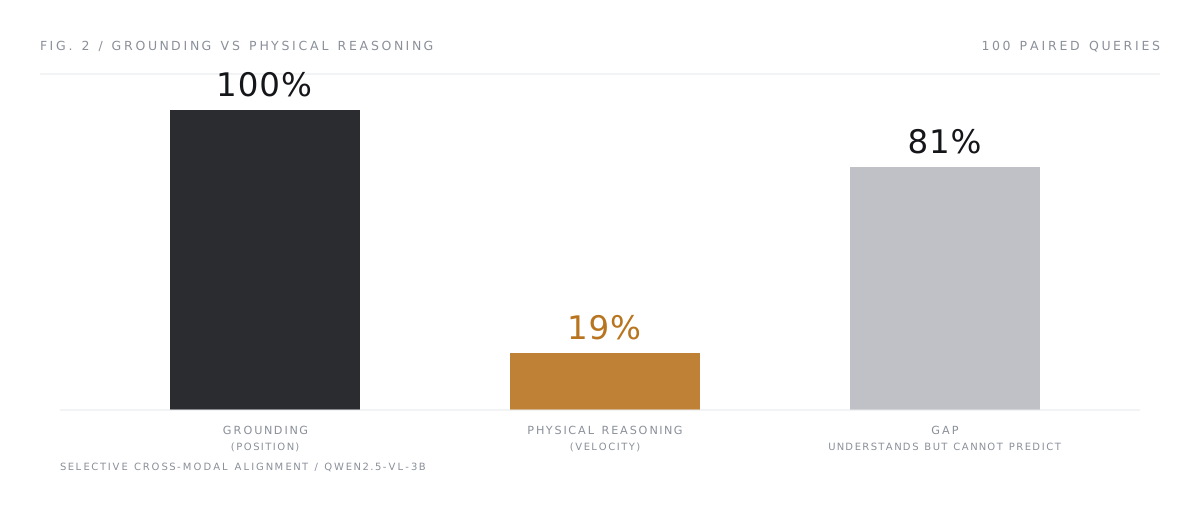
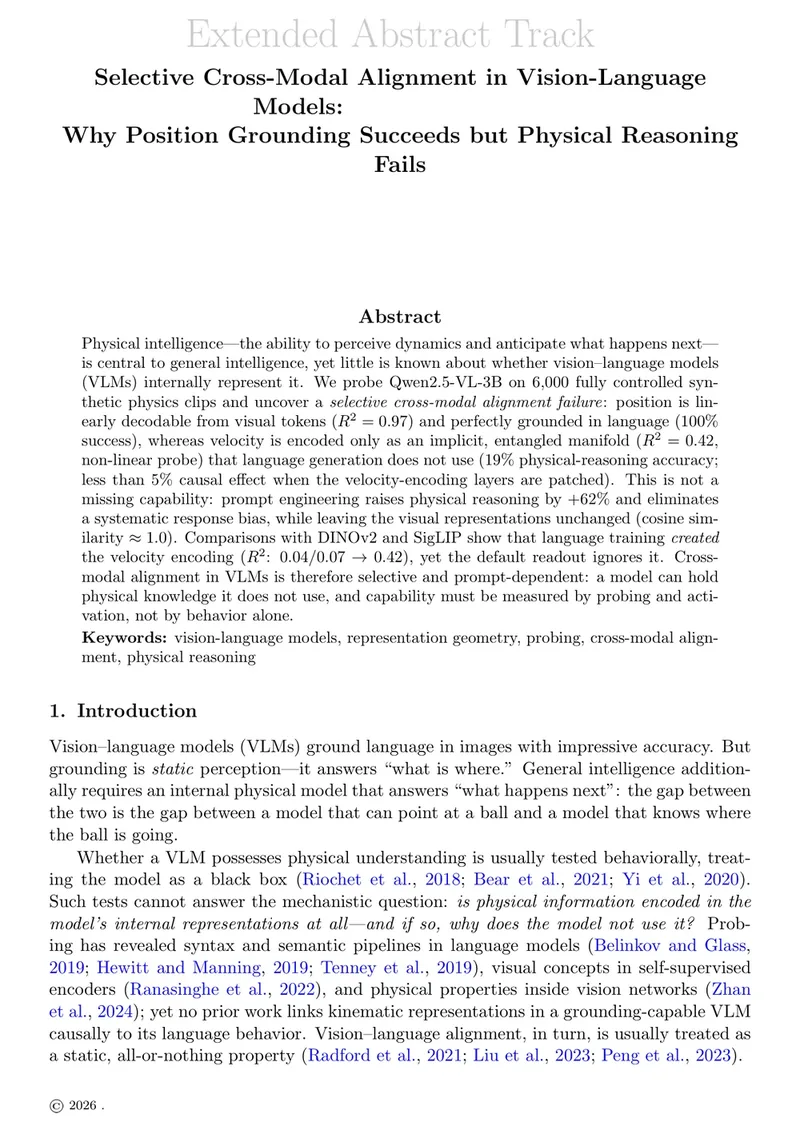
物理智能——感知动态并预判下一步的能力——是通用智能的核心,但视觉语言模型是否在内部表征它,仍然缺少答案。我们在 6,000 条完全可控的合成物理片段上探测 Qwen2.5-VL-3B,发现了一种“选择性跨模态对齐失败”:位置可以从视觉 token 中线性解码(R² = 0.97),并在语言中完美接地(100%);速度却只以隐式、纠缠的流形存在(R² = 0.42,非线性探针),语言生成并不使用它(物理推理准确率 19%;对速度编码层做干预的因果效应低于 5%)。这不是能力缺失:提示工程把物理推理提升了 62%,并消除了系统性的回答偏差,同时不改变视觉表征(余弦相似度约 1.0)。与 DINOv2、SigLIP 的对照说明,速度编码是语言训练“创造”出来的(R²:0.04/0.07 → 0.42),但默认读出路径忽略了它。视觉语言模型中的跨模态对齐因此是选择性的、依赖提示的:模型可以持有它不使用的物理知识;能力必须通过探测与激活来测量,而不能只看行为。
Read the English abstract ↗
Physical intelligence—the ability to perceive dynamics and anticipate what happens next—is central to general intelligence, yet little is known about whether vision–language models (VLMs) internally represent it. We probe Qwen2.5-VL-3B on 6,000 fully controlled synthetic physics clips and uncover a selective cross-modal alignment failure: position is linearly decodable from visual tokens (R² = 0.97) and perfectly grounded in language (100% success), whereas velocity is encoded only as an implicit, entangled manifold (R² = 0.42, non-linear probe) that language generation does not use (19% physical-reasoning accuracy; less than 5% causal effect when the velocity-encoding layers are patched). This is not a missing capability: prompt engineering raises physical reasoning by +62% and eliminates a systematic response bias, while leaving the visual representations unchanged (cosine similarity ≈1.0). Comparisons with DINOv2 and SigLIP show that language training created the velocity encoding (R²: 0.04/0.07 → 0.42), yet the default readout ignores it. Cross-modal alignment in VLMs is therefore selective and prompt-dependent: a model can hold physical knowledge it does not use, and capability must be measured by probing and activation, not by behavior alone.
- vision-language models
- representation geometry
- probing
- cross-modal alignment
- physical reasoning
一、研究问题
视觉语言模型可以非常流畅地描述一段视频:球在滚下斜坡,杯子在坠落,人在走路。 但真正的问题要更窄一些——这些描述里,哪些属性真的在模型内部被表征了, 哪些只是从语言先验里推断出来的?
论文研究选择性跨模态对齐:在同一个表征、同一批数据上, 模型可能很好地接地视觉世界的某个属性,却在另一个属性上失败。 我们选择物理运动作为探针对象,因为它有可分离的属性—— 位置是空间的、静态的,速度是关系的、时间的。 如果一个模型能谈论两者,却只表征了其中一个,差异应该能在探针里被看见。
模型学会了用正确的方式谈论运动,却没有建立运动所需要的东西。 —— 论文结论
二、实验设置
我们在 Qwen2.5-VL-3B 上做了一组完全可控的探测实验: 6,000 条合成物理片段,每条片段一次只改变一个属性——位置、速度、方向、碰撞。 对每条片段提取隐藏状态,训练简单的线性探针(以及非线性探针), 再把探针的准确率与模型直接回答问题的表现作比较;随后对速度编码层做干预, 观察因果效应,并与 DINOv2、SigLIP 两个纯视觉编码器对照。
控制变量很重要:合成视频不能替代真实世界,但它让我们在改变视觉变量的同时保持语言不变。 如果像素变化时模型的描述也跟着变,那描述就接地在某个东西上。
| 项目 | 设置 |
|---|---|
| 模型 | Qwen2.5-VL-3B(对照:DINOv2 / SigLIP) |
| 数据 | 6,000 条完全可控的合成物理片段 |
| 变量 | 位置 · 速度 · 方向 · 碰撞(每条片段只变一个) |
| 探针 | 线性探针 / 非线性探针,逐层解码 R² |
| 评测 | 100 组配对查询;6 种提示写法 × 100 条片段 |
三、三条发现
三个结果分别回答了三个层次的问题:表征里有什么、语言用不用它、它从哪里来。
位置是显式的,速度是流形。
位置可以线性解码,R² = 0.97;速度在线性探针下只有 0.34,非线性探针也只有 0.42, 低于匀速外推基线。运动方向被分散在近 1,280 个维度里。
语言默认不使用它。
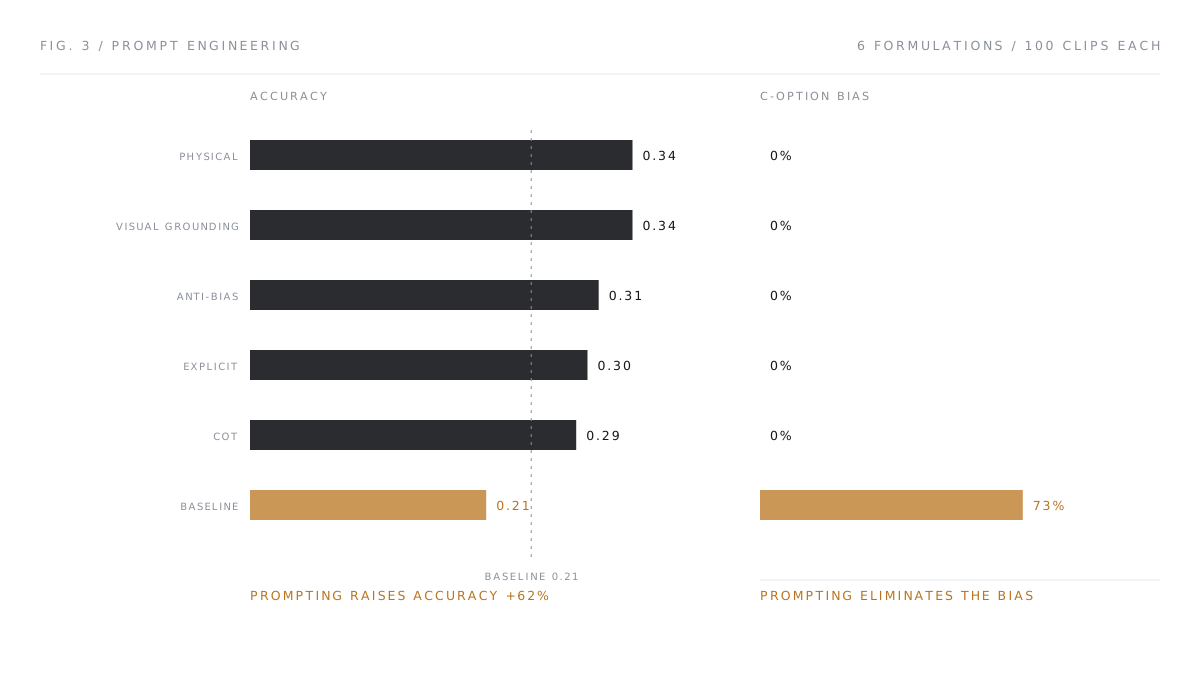
模型对位置的接地成功率是 100%,对运动的预测只有 19%。干预速度层只让准确率变化 4.5%。 提示工程把准确率从 21% 提到 34%(+62%),并消除了 73% 的“C”偏差。
语言训练创造了这种编码。
DINOv2 与 SigLIP 的速度 R² 分别是 0.04 和 0.07,Qwen2.5-VL 达到 0.42。 表征确实被学出来了,但默认读出路径仍然忽略它。
四、图表
以下三张图依据原论文重绘,点击可查看原始尺寸。
五、提示工程
一句仔细写过的提示把物理推理提升了 62%。这个数字是真的,也是一个警告: 它说明信息没有缺席,只是模型默认的读出路径取不到。提示是从外部提供的一套程序—— 它有帮助,但没有改变模型表征了什么。
在六种提示写法、每种 100 条片段的对照里,准确率从 21% 提到 34%,并把 73% 的“C”选项偏差清零; 同时,视觉表征几乎没有变化(余弦相似度约 1.0)。所以论文把提示后的结果单独报告: “模型能推理物理”和“模型可以被提示出更好的物理答案”是两个不同的主张。
六、结论与边界
视觉语言模型中的跨模态对齐因此是选择性的、依赖提示的: 模型可以持有它不使用的物理知识;能力必须通过探测与激活来测量,而不能只看行为。
结果很窄:一个模型家族、3B 参数、合成视频、受控变量。 它不声称更大的模型会以同样的方式失败;它声称接地是选择性的, 并给出了定位这种选择性的方法。
下一步的问题是显然的:能不能训练出一种表征,既分离速度、又不丢掉位置?目前还没有答案。
七、论文与复现
论文为英文撰写的会议扩展摘要,六页、双栏,包含原始图表与参考文献。 PDF、代码与 OpenReview 页面均可公开访问。
- OpenReview openreview.net/forum?id=wAWDfIrPJA
- GitHub github.com/Lucerna-cn/vlm-sees-motion
- 原始页面 muzapar.cn/paper — 含英文摘要与交互式图表
引用 / Citation
Muhtar, M. (2026). Selective Cross-Modal Alignment in Vision-Language Models: Why Position Grounding Succeeds but Physical Reasoning Fails. NeurIPS 2026 Workshop (NeurReps), Extended Abstract.
八、作者与团队
本研究由 LUCERNA 团队成员穆再排尔·穆合塔尔(Muzapar Muhtar)独立完成, 方向为计算机视觉与无人机;论文以扩展摘要(海报)形式发表于 NeurIPS 2026 Workshop(NeurReps)。
团队的另一个公开研究: 基于重参数化 YOLO26n 的轻量化无人机着陆标志检测。
图表依据原论文重绘,论文与图表版权归作者所有。 如需转载、讨论或合作,请联系 official@lucerna.cn。 返回 首页。